VTLA一定要从头训练?触觉+SOTA VLA模型是更好思路
近日,千觉机器人(Xense Robotics)联合牛津大学、加州大学圣地亚哥分校、上海交通大学、中山大学,正式发布两项触觉感知研究的前沿成果——TouchGuide 与 TacUMI。论文已上线 arXiv,项目主页和代码将逐步公开。
视觉告诉我们“looks good”,触觉才能保证“really good”。
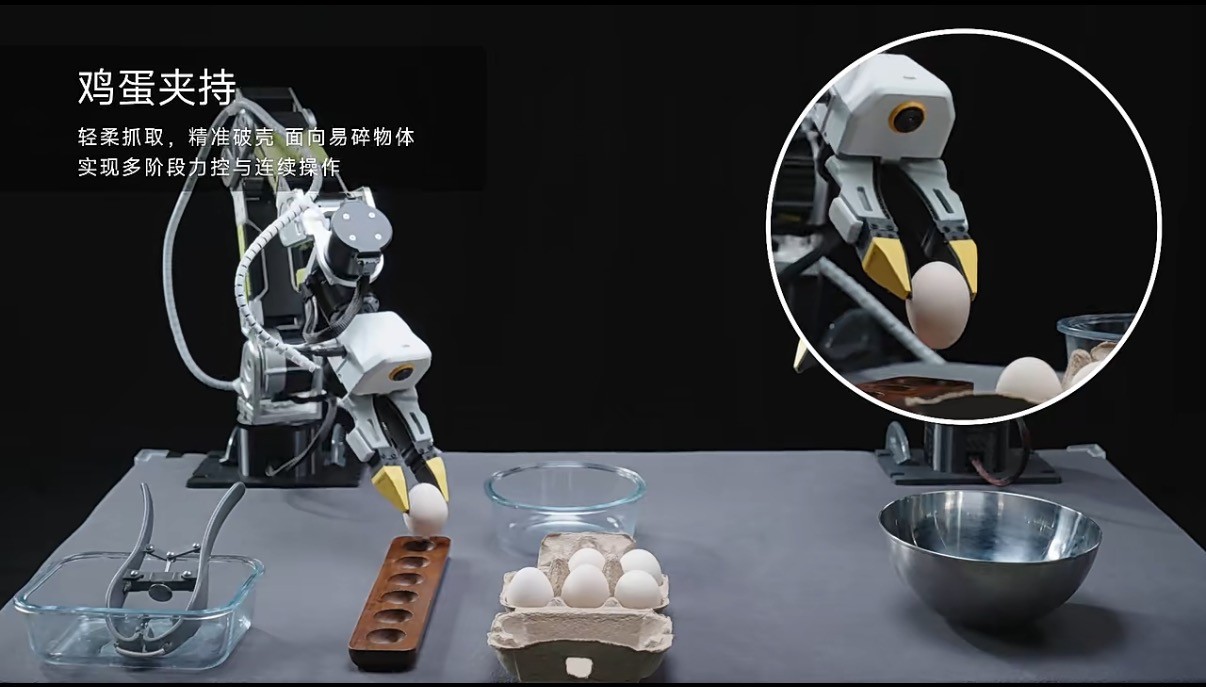
在精细接触操作中,视觉只能告诉我们“看起来可行”的动作,但真正的成功往往取决于视觉和手内信息(即触觉提供的夹爪内接触信息)的共同作用。TouchGuide的核心理念是:让策略在推理阶段拥有触觉,把“看得见”与“摸得到”融合到动作空间里,从而把动作分布推向真实的接触物理。
TouchGuide不是重新训练一个新策略,而是在推理阶段对已有视觉策略进行“触觉引导”。流程上,它先用视觉生成一个粗动作,再由任务相关的接触物理模型(CPM)给出可行性分数,在采样过程中对动作进行修正与引导。CPM 通过少量专家示范进行对比学习,输出“是否符合接触物理”的可行性信号,因此既能用于扩散策略,也能无缝接入流匹配策略,实现跨策略的触觉融合。
为了验证这套推理期触觉引导范式,团队设计了五个典型的接触密集任务:穿鞋带(长时序、精细任务)、薯片传递(易碎物体动态交互)、黄瓜削皮(连续接触与双臂配合)、花瓶擦拭(接触密集操作),以及低数据场景下的开锁(仅 20 条示范、要求高精度)。这些任务覆盖了复杂接触、长时序、脆性物体力控、精细操作与低示范等关键挑战。
结果显示,TouchGuide在不同基础策略与不同触觉模态上都取得稳定提升:例如在 π0.5 上,使用触觉图像的 TouchGuide 平均成功率显著高于视觉基线;在 DP 上同样带来明显收益。更重要的是,它能减少“首次接触”导致的失败,把动作从视觉合理但接触物理不可行的区域拉回到可执行空间,并在不同机器人与不同触觉模态之间保持良好的泛化能力。
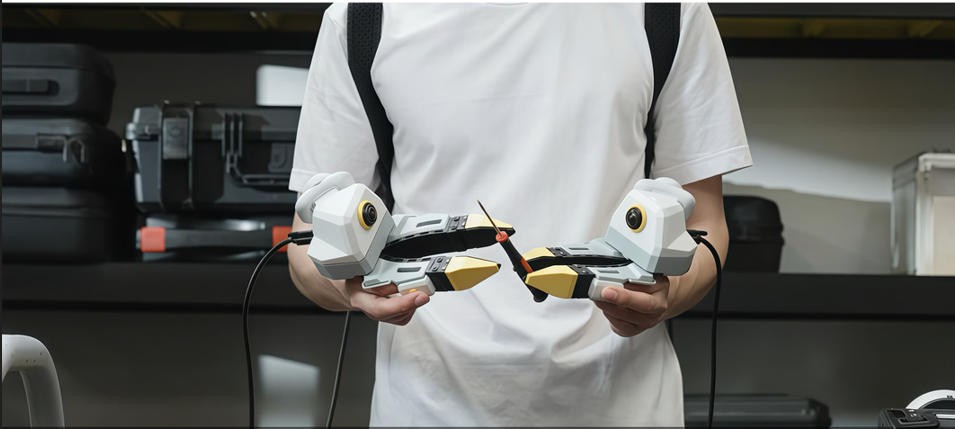
高质量触觉引导的前提是含高质量触觉的多模态数据,因此团队同时推出 TacUMI:一套低成本、高精度的手持式触觉多模态数据采集系统。TacUMI 使用 Vive Tracker 与 Lighthouse 定位来获得准确位姿,通过刚性指套接口实现直接触觉反馈,并将视觉、触觉与位姿在统一管线中同步采集;同时,它在采集端与执行端保持结构一致,可通过适配器快速接入不同机械臂,实现“数据可采、策略可用”的闭环。
硬件设计上,TacUMI以“直接触觉反馈”为核心:刚性指套接口、Xense 触觉传感器、磁编码器、腕部相机与板载端部计算单元提供了高分辨率触觉图像与力场估计的同步采集能力。这种最小化结构与统一接口,使得高精度触觉数据获取更轻量、更可规模化。
扫码咨询购买